Imagine sua porta digital: quem você deixa entrar decide o que acontece com o seu conteúdo. Quando o assunto é IA, o porteiro se chama robots.txt. É aqui que você escolhe quais bots podem explorar suas páginas e quais ficam do lado de fora, sem drama técnico e com controle real.
configurar robots.txt para chatgpt: o tema ganhou peso porque muita gente quer aparecer nas respostas de IA sem entregar o acervo para treino irrestrito. Publicadores, infoprodutores e e-commerces no Brasil buscam visibilidade e proteção ao mesmo tempo. O caminho passa por separar bots de treino dos de busca/citação, mantendo o Googlebot livre e protegendo áreas sensíveis.
O erro comum: copiar um template genérico ou bloquear tudo. Essa pressa costuma cortar tráfego de fontes valiosas e não impede scrapers que ignoram regras. Também é fácil bagunçar diretivas e travar recursos críticos (imagens, JS, CSS), derrubando desempenho e UX.
O que você vai aprender: um passo a passo prático, com estratégia “block training, allow search”, exemplos prontos de diretivas, validação por logs, medições no GA4/Search Console e cuidados com LGPD. A meta é clareza: você escolhe quem acessa o quê, mantendo SEO forte e presença em respostas de IA quando fizer sentido.
O que muda ao configurar robots.txt para ChatGPT e outros agentes de IA em 2026
A mudança central é o controle fino: em 2026, configurar o robots.txt para IA virou um jogo de separar quem treina modelos de quem ajuda sua marca a ser descoberta, sem quebrar o SEO clássico.
Objetivo: separar treino de modelos e descoberta em busca
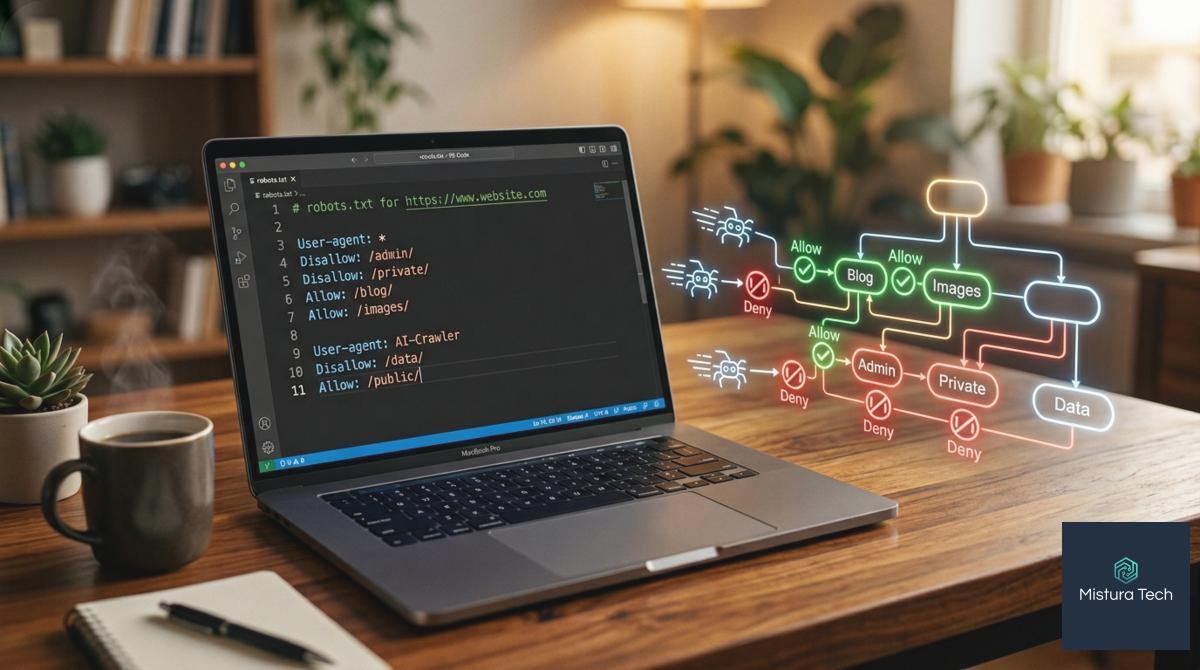
Block training, allow search: a meta é bloquear bots de treino (como GPTBot) e permitir bots de busca/citação (como OAI-SearchBot, ChatGPT-User e PerplexityBot) para manter descoberta.
Segundo a documentação da OpenAI, GPTBot alimenta o treino de modelos e OAI-SearchBot serve resultados no ChatGPT Search. Em outras palavras, GPTBot ≠ OAI-SearchBot. Preserve essa distinção no arquivo.
Evite tocar no Googlebot. O foco é o equilíbrio: proteja o acervo de treino e mantenha canais de descoberta vivos.
Impactos em SEO, E-E-A-T e distribuição de conteúdo
Mantenha o Googlebot: bloquear GPTBot não corta indexação do Google. Já bloquear bots de busca de IA tende a reduzir menções e citações nas respostas dessas plataformas.
O básico de SEO segue valendo: conteúdo útil, velocidade, arquitetura limpa e sinais de E-E-A-T. A diferença agora está na distribuição: permitir OAI-SearchBot e semelhantes pode ampliar alcance em buscas de IA.
Pense nisso como abrir vitrines certas e fechar o estoque. Você mostra o produto, mas não doa a prateleira inteira para treino.
O que o robots.txt faz e o que ele não impede (scrapers)
robots.txt não é muro: é um padrão de boa-fé. Ele orienta crawlers que respeitam regras, mas não impede scrapers que ignoram políticas.
Para proteção real, combine camadas: autenticação, paywall, cabeçalhos, limitação de taxa e monitoramento de IPs. Cuidado com “Disallow: /” geral: você pode bloquear até recursos críticos sem querer.
Use o robots.txt como semáforo, não como cofre. O cofre são as medidas técnicas e contratuais.
Diferenças entre bloquear GPTBot e manter Googlebot
GPTBot ≠ OAI-SearchBot: bloquear GPTBot sinaliza “não usar em treino”. Permitir OAI-SearchBot e ChatGPT-User mantém presença no ChatGPT Search.
Mantenha o Googlebot liberado para preservar indexação. Exemplo prático, em linhas: “User-agent: GPTBot / Disallow: /”; “User-agent: OAI-SearchBot / Allow: /”; “User-agent: Googlebot / Allow: /”.
Valide nos logs: confira o cabeçalho User-Agent e o IP. Teste em staging, depois em produção, para evitar cortes acidentais de tráfego.
Riscos práticos para publishers e infoprodutores no Brasil
Risco de perder alcance: bloquear bots de descoberta pode reduzir citações em respostas de IA e tráfego de referência qualificado.
Em compliance, o robots.txt ajuda na governança, mas não substitui contratos, políticas e medidas técnicas. A LGPD segue valendo quando houver dados pessoais; trate isso fora do robots também.
Revise diretórios sensíveis (área paga, mídia e APIs) e evite bloquear CSS/JS, o que derruba UX e sinais de qualidade. Monitore, ajuste, repita.
Mapeie e classifique os user-agents de IA que importam
Comece pelo papel de cada bot: mapeie quem treina modelos, quem mostra seu site em buscas de IA e quem acessa sob demanda do usuário. Essa triagem guia todas as regras.
Bots de treino: GPTBot, ClaudeBot, CCBot e similares
GPTBot é treino: a OpenAI classifica o GPTBot como coletor para treinamento de modelos. ClaudeBot e o CCBot (Common Crawl) também alimentam datasets amplos. Bloquear esses agentes sinaliza “não use meu conteúdo para treino”.
As strings de User-Agent mudam com o tempo. Trate por famílias (ex.: “GPTBot”) e monitore variações. Evite regras dependentes de versões.
Bots de busca/citação: ChatGPT-User, OAI-SearchBot, PerplexityBot
OAI-SearchBot é busca: permite que páginas apareçam no ChatGPT Search com citações. Já o ChatGPT-User executa fetch sob solicitação do usuário; a própria OpenAI indica que “robots.txt may not apply” a essas ações iniciadas pelo usuário.
PerplexityBot atua em descoberta/citação para a plataforma Perplexity. Se você quer alcance em respostas de IA, autorize os bots de busca/citação e gerencie treino à parte.
Regras especiais e pegadinhas (ex.: prefetch, mirrors, proxies)
Prefetch e proxies: alguns acessos vêm por camadas de cache, mirrors ou redes de terceiros. Eles podem mascarar a origem real do robô.
Cheque padrão de requisições, intervalos e cabeçalhos. Combine User-Agent com IP conhecido ou métodos de verificação do provedor quando existir documentação.
Como manter a lista atualizada com segurança
Separe por função: mantenha grupos de treino, busca/citação e sob demanda. Atualize regras quando as documentações mudarem e valide em staging.
Evite bloqueios amplos que atinjam Googlebot. Monitore mudanças de User-Agent e comunicações oficiais. Lembre que robots.txt é sinal de governança; termos de uso e contratos seguem necessários.
Validação em logs: identificando o header User-Agent
Valide pelo User-Agent: confirme a string declarada e cruze com padrão de IP e taxa de acesso. Para Googlebot, há processos de verificação via DNS descritos pela própria Google.
Registre eventos, horários e endpoints. Se notar variações estranhas, ajuste as regras e reavalie a família do agente. Logs são seu “radar” contínuo.
Passo a passo de configuração do robots.txt (com exemplos práticos)
Vamos ao prático: você vai definir quem pode rastrear, quem não pode e como cobrir brechas com meta tags e headers. O foco é proteger treino e manter visibilidade em busca.
Estratégia padrão: bloquear treino e permitir busca
Bloqueie treino, permita busca: negue GPTBot (treino) com “User-agent: GPTBot / Disallow: /” e permita OAI-SearchBot para citações no ChatGPT Search. Trate ChatGPT-User como fetch sob demanda; a OpenAI observa que robots.txt pode não se aplicar a ações iniciadas pelo usuário. Mantenha Googlebot liberado.
Replique a lógica para outros agentes de treino e de busca da sua realidade. Valide em staging antes de publicar em produção.
Sintaxe correta: User-agent, Allow, Disallow e curingas
A base é simples: use “User-agent”, “Allow” e “Disallow”. Lembre que robots.txt controla rastreamento, não remoção do índice; para desindexar use meta robots ou X-Robots-Tag no HTTP.
Curingas e âncoras exigem cuidado. Prefira regras curtas por diretório e complemente com headers quando o alvo não for HTML.
Exemplos prontos para WordPress, SaaS e e-commerces
WordPress (núcleo): “Disallow: /wp-admin/” e “Allow: /wp-admin/admin-ajax.php”. Para treino, adicione “User-agent: GPTBot / Disallow: /” e permita “User-agent: OAI-SearchBot / Allow: /”.
SaaS/e-commerce: bloqueie áreas internas como “/app/”, “/account/”, “/checkout/” e “/cart/”. Em downloads e PDFs, retorne X-Robots-Tag: noindex. Em buscas com parâmetros, reduza crawl e trate duplicações com regras por caminho e sinalização noindex.
Regras por diretório: área paga, mídia e API
Área paga: priorize autenticação e autorização; robots.txt não protege conteúdo. Em mídia sensível, combine “Disallow” com X-Robots-Tag: noindex para imagens/arquivos. Para APIs, bloqueie no servidor e exija chaves; não confie só no robots.
Para imagens específicas, use diretivas de imagem documentadas pelo Google quando aplicável.
Fallbacks: meta robots, headers e autenticação
Meta e headers cobrem brechas: aplique “noindex” via meta robots em HTML e via X-Robots-Tag em PDFs, CSVs e mídia. Quando o dado não deve ser público, a solução real é autenticação e controle de acesso, não apenas diretivas.
Teste em ambiente controlado, verifique respostas HTTP e confirme o comportamento com ferramentas e revisão de logs.
Teste, monitore e ajuste continuamente
Ciclo sem fim, mas sob controle: seu robots.txt só funciona de verdade quando você testa, mede e ajusta. Pense como um painel de voo: checagens antes da decolagem, instrumentos ligados no ar e correções rápidas quando algo foge da rota.
Testes em ambiente de staging e produção
Teste em staging primeiro: replique estrutura de URLs, redirects, canonicals, headers e autenticação. Assim, você valida o efeito real antes de mexer no tráfego.
Em produção, publique mudanças pequenas e reversíveis. Prefira regras por diretório e por User-Agent, com janelas de tempo claras para reverter.
Lembre: o robots.txt controla acesso de crawl, não renderização, ranking ou remoção do índice. Ajuste com calma e valide o resultado no mundo real.
Monitoramento por logs e ferramentas de observabilidade
Olhe os logs todo dia: monitore GET /robots.txt, picos de crawl, e códigos 200/403/404. Isso mostra quem respeita regras e onde há carga excessiva.
Padronize campos úteis: timestamp, IP, caminho, status, bytes, referer e User-Agent. É o mínimo para correlacionar mudanças com picos ou quedas.
Em observabilidade, acompanhe IP/ASN, país, frequência por rota e taxa de 4xx/5xx. Diferencie bots de IA de busca tradicional para agir com precisão.
Medição no GA4 e no Search Console
Meça em duas frentes: o Search Console mostra descoberta e visibilidade; o GA4 revela comportamento e conversão.
Em 2026, o Google documenta relatórios de AI features/AI Overviews no Search Console. Isso permite avaliar efeitos de IA sem depender só de analytics.
No GA4, use UTMs, filtros e segmentações. Se a jornada não carrega tags, o Measurement Protocol ajuda a registrar eventos server-side.
Compare Search Console com GA4. Divergências costumam vir de atribuição, consentimento, bloqueios de navegador ou tráfego não humano.
Ajustes por campanha e sazonalidade
Ajuste por janela de tempo: libere seções para campanhas e reverta no fim. Evita conteúdo promocional antigo circulando.
Antes de picos como Black Friday, revise bloqueios. Um “Disallow” no lugar errado pode cortar descoberta quando a demanda sobe.
Se o conteúdo muda rápido, prefira controles finos: noindex, nosnippet e limites de snippet. Você regula a exibição sem fechar o acesso inteiro.
Checklist de governança e LGPD
Defina dono e trilha: registre quem muda o robots.txt, data, motivo, escopo e prazo. Isso cria responsabilidade e histórico.
Classifique conteúdo por sensibilidade e aplique a menor exposição necessária. Para dados pessoais, alinhe base legal, retenção e finalidade à LGPD.
Revise periodicamente crawlers e fornecedores permitidos. Busque coerência entre política editorial, privacidade e canais de distribuição em IA.
Conclusão e próximos passos
Fechando o ciclo: configurar o robots.txt para IA é separar treino de descoberta, sem arriscar seu SEO. Bloqueie bots de treino, permita bots de busca. Teste em staging, publique com cuidado, monitore por logs. Meça impacto em GA4 e Search Console, e mantenha governança e LGPD no centro.
Pronto para aplicar agora? A Mistura Tech ajuda você a montar e validar a estratégia bloquear treino, permitir busca, configurar regras por diretório, e instrumentar logs, GA4 e Search Console. Agende uma auditoria técnica inicial para sair com seu robots.txt ajustado, plano de testes e um checklist claro de próximos passos.
Key Takeaways
Domine como configurar o robots.txt para ChatGPT e outros crawlers de IA em 2026, equilibrando proteção de conteúdo e alcance em buscas de IA com testes e medições contínuas:
- Separe treino de busca: Bloqueie GPTBot/ClaudeBot/CCBot para evitar treinamento e permita OAI-SearchBot e PerplexityBot para citações e descoberta.
- Mantenha o Googlebot: Preserve indexação e ranking orgânico liberando Googlebot; decisões de IA não substituem o SEO clássico.
- ChatGPT-User sob demanda: Fetch iniciado pelo usuário pode não seguir robots.txt; use autenticação, rate limiting e monitoramento por logs.
- Sintaxe e limites corretos: Use User-agent, Allow e Disallow com precisão; para desindexar, aplique meta robots ou X‑Robots‑Tag no HTTP.
- Exemplos por stack: Em WordPress, Disallow /wp-admin/ e Allow admin-ajax; em SaaS/e-commerce, bloqueie /app/, /account/, /checkout/ e use X‑Robots‑Tag: noindex em PDFs e downloads.
- Diretórios sensíveis e APIs: Áreas pagas e APIs exigem autenticação e bloqueio no servidor; robots.txt não é controle de acesso.
- Teste e monitore sempre: Valide em staging, faça mudanças reversíveis, audite GET /robots.txt, 2xx/4xx/5xx, User-Agent e IP/ASN, e ajuste por campanha e sazonalidade.
- Meça e governe: Acompanhe AI features no Search Console, use UTMs e Measurement Protocol no GA4, compare métricas e mantenha governança e LGPD.
A eficácia nasce do controle seletivo, validação contínua e métricas claras: bloqueie treino, permita busca e conduza tudo com governança responsável.
FAQ — configurar robots.txt para ChatGPT e crawlers de IA (2026)
Bloquear GPTBot afeta meu SEO no Google?
Não diretamente. O robots.txt controla rastreamento, não ranking. Se manter o Googlebot liberado, o impacto tende a ser na visibilidade em respostas de IA e citações, não no ranking orgânico.
Devo permitir OAI-SearchBot e PerplexityBot?
Se você quer aparecer em respostas de IA com links e citações, sim. A estratégia comum é bloquear bots de treino e permitir bots de busca/citação. Ajuste conforme políticas e objetivos do negócio.
O ChatGPT-User respeita o robots.txt?
Nem sempre do mesmo modo que um crawler. É um fetch acionado pelo usuário, e as regras podem não se aplicar integralmente. Use também autenticação, rate limiting e monitoramento por logs.
Como testar e medir mudanças no robots.txt?
Teste em staging, publique mudanças pequenas, valide por logs (User-Agent, códigos 2xx/4xx/5xx) e acompanhe GA4 e Search Console. Em 2026, relatórios de AI features/AI Overviews ajudam a avaliar efeitos de IA.
Robots.txt resolve LGPD e proteção de conteúdo?
Não. Robots.txt é um sinal técnico de boa-fé. Para LGPD, você precisa base legal, minimização, retenção, transparência e controles de acesso. Combine com meta/X-Robots-Tag, autenticação e contratos.