Como deixar o WordPress rápido de verdade: o que move o ponteiro e o que é mito
Deixar o WordPress rápido com ações que movem o ponteiro. Descubra mitos, ganhos reais e um roteiro prático para resultados hoje.
Por Rodrigo Monteiro18 de outubro de 202613 min de leitura
Resumo em 30 segundos
- 01Meça com dados reais: Use CrUX no PageSpeed e Search Console; foque em LCP ≤ 2,5 s, INP ≤ 200 ms e CLS ≤ 0,1 no percentil 75; Lighthouse serve para depurar.
- 02Ataque o TTFB primeiro: Busque TTFB < 800 ms; habilite HTTP/3 e TLS 1.3, use cache no servidor e CDN/edge; plugin não corrige servidor lento.
- 03Cache certo, sem excesso: Página para anônimos e objeto com Redis para dinâmico; não cacheie áreas logadas e checkout; valide HIT/MISS e invalidação.
- 04Imagens modernas e leves: Converta para WebP/AVIF (25–55% menores), gere srcset/sizes, defina width/height; use fetchpriority=high na imagem LCP e lazy load no resto.
- 05Menos requisições e JS: Inline do Critical CSS, adie/delay de JS e use preload/preconnect apenas no essencial; ganhos claros de LCP/INP.
- 06Pilha enxuta de plugins: Evite 15 “otimizadores” brigando; prefira um bom cache + mídia + gestor de scripts; remova scripts de terceiros desnecessários e meça com Query Monitor.
- 07CDN e protocolos modernos: Entregue estáticos (e HTML quando possível) na borda para reduzir latência global; ative HTTP/3/QUIC e DNS rápido.
- 08Saiba quando migrar: Se o TTFB segue alto com cache e baixo tráfego, há limite de CPU/I/O; suba para VPS/gerenciado com NVMe e PHP 8.3 seguindo checklist de migração sem downtime.
Velocidade é como fila de caixa em dia de promoção: se anda, você compra; se trava, você vai embora. Com site é igual. Quem tenta navegar e sente tudo arrastado desiste em poucos segundos. Eu vejo isso todos os dias em negócios ótimos que perdem vendas por puro atraso na entrega da página.
Por que isso importa agora: o Google observa sinais de experiência real como Core Web Vitals e uma métrica de resposta chamada INP. Na prática, páginas leves, estáveis e rápidas tendem a subir, enquanto páginas que demoram a reagir caem em relevância. Se o objetivo é deixar o WordPress rápido, vale focar no que mexe de verdade no relógio: servidor respondendo bem, menos tralha carregando e mídia otimizada.
Onde muita gente erra: caçar pontos no PageSpeed como se fosse videogame, instalar cinco plugins de “otimização” brigando entre si, ou minificar tudo esperando milagre. Isso costuma gerar quebra de layout, bugs no checkout e quase nada de ganho real. O que costumo ver é site com vilões claros — imagem gigante, cache ausente e JS bloqueando — escondidos por soluções cosméticas.
O que este guia entrega: um caminho direto ao ponto, baseado no que realmente melhora a experiência e o ranking. Vamos do diagnóstico simples ao ajuste que move o ponteiro: medir LCP/INP sem pânico, cortar gargalos de TTFB, configurar cache com segurança, converter imagens do jeito certo e reduzir requisições inúteis. Você sai com um roteiro prático para aplicar hoje e sentir a diferença ainda esta semana.
Meça antes: onde está o gargalo do seu site
Comece pelo que conta para o Google: meça com dados reais (CrUX) no PageSpeed e no Search Console, compare com o laboratório do Lighthouse e anote seus limites: LCP até 2,5 s, INP até 200 ms e CLS até 0,1 no percentil 75. Olhe também o TTFB abaixo de 800 ms. Isso mostra se o gargalo é servidor, imagem, JavaScript ou layout.
Quais métricas importam hoje: LCP, CLS e INP na prática
Foque nos três Core Web Vitals: LCP até 2,5 s (carregamento do maior bloco), INP até 200 ms (resposta aos cliques) e CLS até 0,1 (estabilidade visual), avaliados no percentil 75 dos dados de campo.
Na minha experiência, o LCP costuma ser a imagem hero. O INP piora com scripts de terceiros (chat, consentimento, sliders). O CLS cresce quando imagens não têm dimensões. Use o relatório do CrUX para mobile e desktop e valide no site real.
Como ler PageSpeed Insights, Lighthouse e Search Console sem paranoia
Lighthouse é laboratório, não meta: use a nota para depurar, mas decida com o CrUX e o relatório de Core Web Vitals no Search Console.
Veja mobile primeiro. Leia o “Oportunidades” como lista de causas, não como ranking de tarefas. Instale um RUM simples (biblioteca web-vitals) para saber qual elemento causa o LCP e qual script trava o toque.
TTFB, CPU do servidor e banco de dados: sinais de hosting fraco
Teste página em cache vs. sem cache: se o TTFB é alto nas duas, o caminho de rede/host está fraco; se só sem cache é alto, o problema é PHP/MySQL.
Busque TTFB abaixo de 800 ms como alvo prático, mais baixo em páginas cacheadas. Use WebPageTest para ver o waterfall. Em staging, rode Query Monitor e encontre plugins com queries lentas ou autoload gigante.
Páginas de dinheiro primeiro: medir homepage, produto e topo de funil
Priorize onde o dinheiro entra: meça a home, uma página de produto/serviço e uma página de captura. Corrija nelas primeiro e só depois escale.
Compare o trio LCP/INP/CLS e o TTFB nessas URLs em três horários. Isso evita otimizar páginas que não impactam receita. Registre o antes e depois para não se perder.
Identifique vilões: plugins pesados, temas inchados, scripts de terceiros
Corte o que trava a fila: desative temporariamente plugins pesados, teste sem o construtor visual e remova scripts de terceiros não essenciais. Meça a cada passo.
Casos comuns: widget de chat que piora o INP, banner de consentimento carregado cedo, slider que eleva o LCP, tema antigo com CSS/JS gigantes. Defina dimensões das imagens para segurar o CLS e carregue o hero de forma prioritária.
As otimizações que dão ganho real: cache, imagem e requisições
Quer ganho real agora: ataque três frentes em conjunto — cache de página e cache de objeto bem definidos, WebP e AVIF com tamanhos certos e menos idas ao servidor com Critical CSS, adiamento de JS e preload e preconnect pontuais. Isso derruba TTFB mais baixo, melhora LCP e protege INP/CLS.
Cache de página e objeto: quando usar plugin e quando usar servidor
Use página para anônimos e objeto para dinâmica: cache de página guarda o HTML e voa em visitas públicas; cache de objeto (ex.: Redis persistente) acelera queries quando não dá para servir HTML estático.
Evite cachear áreas logadas, carrinho e checkout. Teste invalidação e privacidade. Em servidores LiteSpeed, o motor nativo entrega páginas em cache antes do PHP. Em outros, plugins de página + Redis funcionam bem, desde que você não duplique camadas.
Imagens em WebP/AVIF e tamanhos responsivos sem quebrar design
Converta e ajuste srcset: WebP e AVIF reduzem o peso de forma visível (WebP cai tipicamente 25–35% vs JPEG; AVIF costuma ficar 40–55% menor). Use fetchpriority=”high” na imagem LCP e defina width/height para segurar o CLS.
Sirva AVIF onde houver suporte e WebP como fallback. Gere múltiplos tamanhos e deixe o navegador escolher via srcset e sizes. Teste a qualidade no hero; troque apenas se o visual ficar igual.
Reduzir requisições: adiar JS, inline do crítico e pré-carregamentos úteis
Menos bloqueio, mais pintura: injetar Critical CSS no HTML e adiar o resto pode cortar LCP em centenas de milissegundos. Aplique preload e preconnect apenas ao essencial (fonte principal, imagem LCP, origem do CDN).
Adie JS que não é vital e considere “delay” até interação para widgets pesados. Não exagere no inline: mire algo perto de 14 KB para evitar um RTT extra no primeiro paint.
CDN na medida certa: estáticos na borda e DNS rápido
Coloque os arquivos perto do usuário: use CDN para CSS, JS, imagens e, se possível, cache de HTML na borda para anônimos. Isso derruba latência e ajuda o LCP de quem está longe do seu servidor.
Não duplique camadas iguais. Uma pilha saudável é página + objeto + CDN. Combine com HTTP/3/QUIC habilitado e um provedor de DNS rápido para resolver mais cedo.
Tuning do WordPress: Redis, OPcache, PHP 8.x e autoload enxuto
Otimize a base primeiro: PHP 8.2/8.3 com OPcache ligado, Redis persistente para o cache de objeto e autoload das opções limpo reduzem trabalho em cada requisição.
Meça com Query Monitor antes e depois. Observe queries lentas, autoloads gigantes e endpoints externos devagar. Ajuste TTLs, monitore memória e evite flush global frequente — baixa taxa de acerto indica configuração errada, não “falta de sorte”.
O que quase não muda nada (e todo mundo continua fazendo)
Evite gastar energia no detalhe que não move o ponteiro: truques de “micro ganho” costumam render frações, enquanto os vilões seguem vivos. Em 2026, o que derruba resultado é LCP ruim, INP travado e CLS saltando. Dados do CrUX mostram muitos sites ainda falhando no mobile, então foco vale ouro.
Minificar obsessivamente e trocar de fonte por 1% de ganho
Ganho mínimo, risco alto: minificar ao extremo e trocar de fonte sem critério quase não mexe no LCP quando imagens e cache ainda pesam. O ganho tende a ser pequeno, e quebras de layout são comuns.
Melhor caminho: hospedar fontes localmente, limitar famílias e pesos e usar estratégia de exibição. Foque primeiro em WebP/AVIF, cache de página e prioridade da imagem LCP; isso costuma render impacto real nas métricas.
Desativar emojis, embeds e heartbeats achando que virou foguete
Quase zero impacto no real: cortar emojis, embeds e o heartbeat reduz poucos KB e raramente melhora TTFB ou INP de forma mensurável.
Vale ajustar onde faz sentido (especialmente no admin). No front, a diferença é pequena perto de otimizar servidor, mídia e JavaScript que bloqueia interação.
Usar 15 plugins de “otimização” brigando entre si
Menos é mais em performance: empilhar vários plugins de “otimização” cria conflito, duplica tarefas (minificação, cache) e pode piorar INP e CLS.
Escolha uma pilha clara: um bom plugin de cache, um de mídia e, se necessário, um gestor de scripts por página. Meça com Query Monitor e desative o que não entrega.
AMP, sliders e efeitos: quando só atrapalham a experiência
Firula custa caro no relógio: AMP, sliders e muitos efeitos adicionam JS/CSS e imagens grandes, elevando LCP e causando CLS.
Na prática, carrosséis raramente aumentam conversão e ainda atrasam a pintura do herói. Prefira um visual estável, imagem LCP leve e menos scripts de terceiros na dobra.
“Limpeza de banco” semanal esperando milagre no TTFB
TTFB não é SQL mágico: faxina semanal melhora organização, mas quase não mexe no TTFB, que depende de rede, CPU, PHP e cache.
Ajuda apenas quando há autoload gigante ou queries lentas específicas. Faça diagnóstico antes: se a página em cache segue lenta, o gargalo é infraestrutura, não tabela vazia.
Quando o problema é a hospedagem, não o WordPress
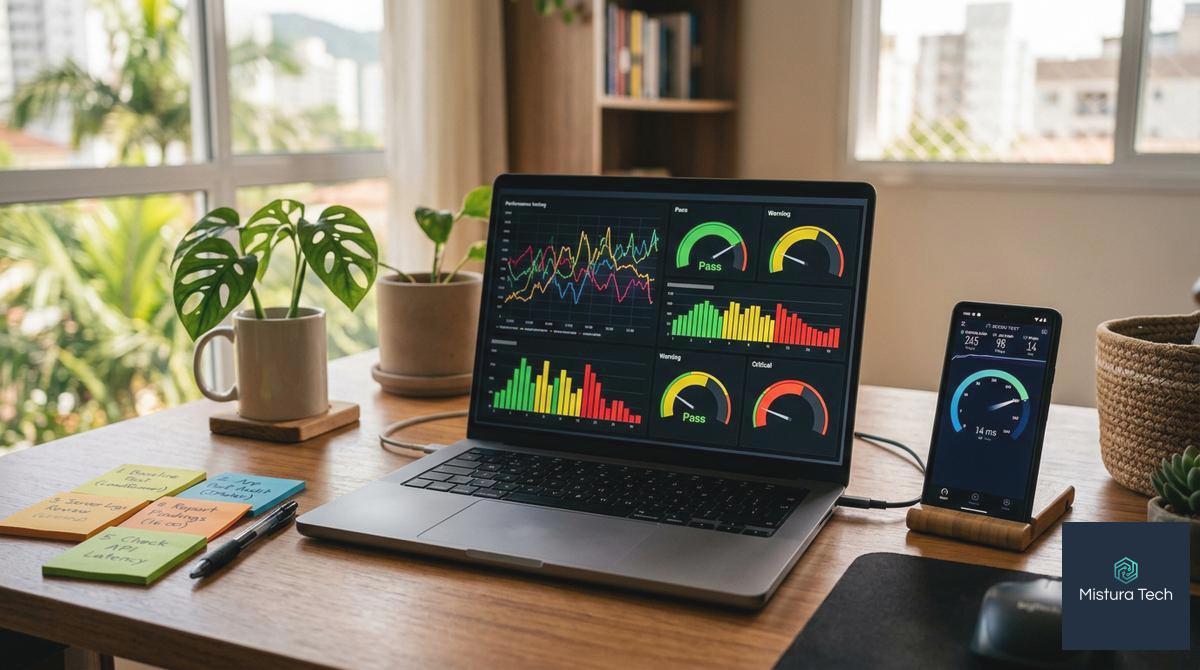
Nem tudo é culpa do WordPress: quando o servidor não dá conta, o site sofre mesmo com código limpo. O sinal mais claro é TTFB consistente alto em horários calmos e com cache ativo. Aí a troca é de infraestrutura, não de plugin.
Como diagnosticar gargalo de infraestrutura em 5 minutos
Compare cache HIT vs MISS: teste a mesma URL com e sem cache e meça o TTFB em três horários. Se ambos são lentos, a infra é o gargalo. Valide com WebPageTest e PageSpeed.
Olhe o “server processing” no waterfall. Registre resultados de regiões perto e longe do seu público. Se o pico derruba tudo, faltam CPU/I/O/workers. Se é lento o dia inteiro, o host é fraco.
Limites de hospedagem compartilhada: CPU, I/O e conexões
Shared tem teto baixo: planos compartilhados limitam CPU, memória, I/O e processos. É comum ver 600–1200 ms de TTFB em shared, contra 150–300 ms em gerenciadas e <200 ms em VPS NVMe bem ajustado.
Veja uso de workers e memória no pico. Se a visita cacheada ainda executa PHP, falta cache no servidor. Se a não cacheada explode o TTFB, o banco ou o PHP estão sobrecarregados.
HTTP/2, HTTP/3, QUIC e TLS: por que o protocolo importa
Protocolos aceleram a conexão: HTTP/2 multiplica requisições no mesmo canal. HTTP/3 com QUIC corta viagens de ida e resolve travas de rede. Ative TLS 1.3 ativo para mão dupla mais rápida.
O ganho aparece em mobile e longas distâncias. Muitos CDNs já entregam HTTP/3 por padrão. Confirme no seu host e force HTTPS moderno no site todo.
Edge cache gerenciado vs. plugin: cenários de e-commerce e pico
Cache na borda segura picos: edge cache gerenciado entrega HTML perto do usuário e reduz fila no servidor. Plugins de cache ajudam, mas não resolvem distância nem rajadas globais.
Em e-commerce, cacheie só páginas anônimas. Carrinho e checkout ficam fora e exigem workers suficientes. Em lançamento ou Black Friday, combine CDN de HTML com page cache local.
Checklist de upgrade: de shared para VPS/gerenciado com zero downtime
Planeje a troca em camadas: clone em staging, atualize para PHP 8.3 com OPcache e habilite Redis. Baixe o TTL do DNS, sincronize arquivos e banco, e agende a virada fora do pico.
Valide cache HIT, erros 5xx e jobs em segundo plano. Só finalize quando o TTFB cair e o Core Web Vitals estabilizar. Mantenha rollback pronto por algumas horas.
Do diagnóstico ao resultado: roteiro de uma tarde
Da medição ao resultado: você mede Core Web Vitals no mundo real, mira LCP/INP/CLS, confere TTFB e ataca o que pesa. Cache bem feito, imagens em WebP/AVIF e menos requisições movem o ponteiro. Micro truques rendem pouco. Se o servidor limita, troque a base: HTTP/3, TLS 1.3, CDN e, quando preciso, upgrade de hospedagem.
Convite da Mistura Tech: quer tirar isso do papel em poucas horas? Agende um Speed Sprint com a Mistura Tech: diagnosticamos LCP/INP/CLS e TTFB, configuramos cache (página/objeto) e CDN/edge, otimizamos as imagens críticas e reduzimos JS bloqueante, priorizando páginas de receita. Você sai com ajustes aplicados e um roteiro claro para manter o WordPress rápido.
A velocidade sustentável nasce de medir certo, resolver o servidor e aplicar otimizações simples e de alto impacto antes de qualquer detalhe cosmético.
Perguntas frequentes
01Como deixar meu site WordPress mais rápido?
Meça LCP/INP/CLS e TTFB, depois ataque o básico: cache de página/objeto, imagens em WebP/AVIF com srcset, adie JS e insira Critical CSS, use CDN e reduza plugins e scripts de terceiros. Valide no PageSpeed Insights e no Search Console.
02Qual o tempo de carregamento ideal para um site?
Como referência, LCP ≤ 2,5 s (bom), INP ≤ 200 ms e CLS ≤ 0,1. Busque 1–2 s no mobile em 4G para páginas chave e TTFB abaixo de ~800 ms (150–300 ms em hospedagens gerenciadas bem configuradas).
03Plugin de cache resolve site lento?
Ajuda muito para visitantes anônimos e derruba TTFB nas visitas seguintes. Não corrige servidor fraco, páginas logadas ou checkout. O ideal é combinar cache no servidor/CDN + cache de objeto (ex.: Redis) + hospedagem rápida.
04Trocar de hospedagem melhora a velocidade do site?
Sim, quando o TTFB segue alto mesmo com cache e otimizações. Migrar de shared para VPS/gerenciado com NVMe, PHP 8.3, HTTP/3 e TLS 1.3 costuma baixar o TTFB. Some CDN na borda e teste antes/depois.
05Como otimizar imagens no WordPress?
Converta para WebP/AVIF, gere tamanhos responsivos (srcset/sizes), defina width/height, aplique lazy load em todas exceto a imagem LCP e use fetchpriority=”high” no hero. Comprima com qualidade equilibrada e distribua via CDN.
Referências Externas
- https://imperiowp.com.br/como-acelerar-o-wordpress-guia-de-velocidade-e-performance-2026/
- https://plugintheme.net/pt-BR/blog/otimizacao-velocidade-wordpress-guia-pratico-2026
- https://blog.openreplay.com/pt/otimizacao-desempenho-wordpress/
- https://www.hostragons.com/pt/blog/como-acelerar-site-wordpress-core-web-vitals/
Rodrigo Monteiro
Fundador da Mistura Tech. Mais de 26 anos de experiência em TI, hoje com foco em IA e automações para empresas: treinamento de equipes, agentes no WhatsApp e integrações com N8N.